Lokalne AI na komputerze to model, który pobierasz raz i uruchamiasz u siebie: bez konta, bez abonamentu i bez wysyłania czegokolwiek do chmury. Najczęściej chodzi o duży model językowy (LLM, z angielskiego large language model), czyli taki, z którym rozmawiasz jak z ChatGPT. Lokalnie działają jednak także inne rodziny modeli: Whisper zamienia mowę na tekst, modele dyfuzyjne pokroju SDXL czy Fluksa generują obrazy, a Stable Audio dźwięk i muzykę. Wszystkie łączy to samo: plik na Twoim dysku i obliczenia na Twoim sprzęcie. Po polsku wypadają dziś naprawdę dobrze, bo mamy własny model Bielik, obok wielojęzycznej Gemmy od Google.
W tym poradniku pokazuję, jak wykorzystać darmowe AI na własnym sprzęcie: od czego zacząć, żeby uruchomić je w kwadrans, które modele lokalne pobrać na początek i jak czytać ich nazwy, żeby nie ściągnąć czegoś, co się nie zmieści. Na koniec odpowiadam na najczęstsze pytanie: jaki sprzęt jest do tego potrzebny i kiedy naprawdę potrzebujesz dedykowanej karty graficznej.
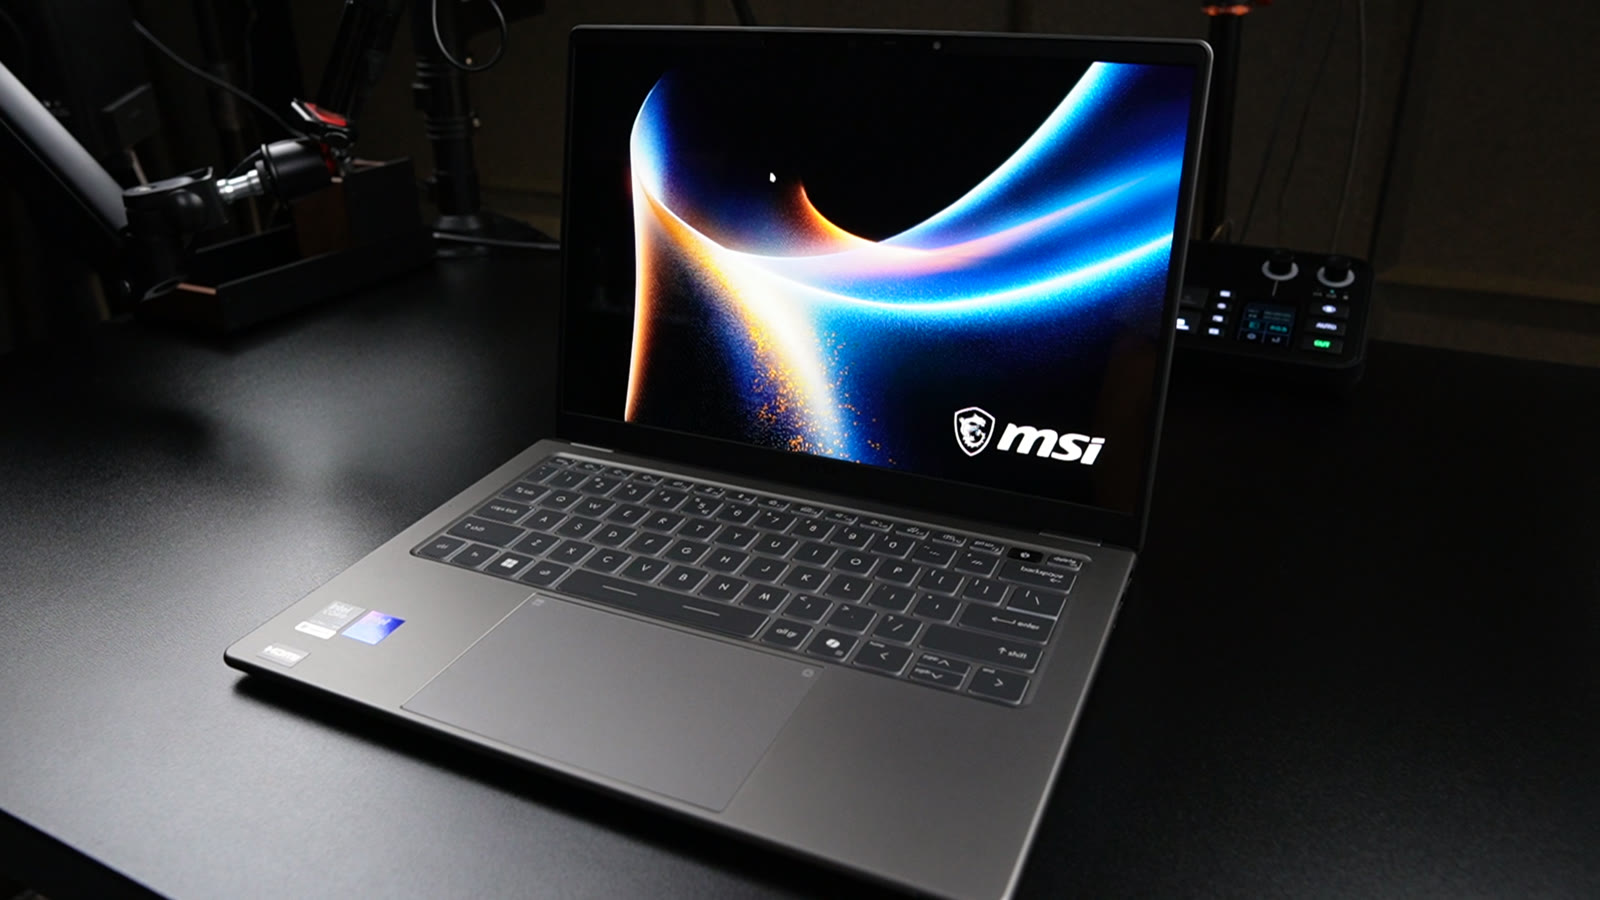
Lokalne modele AI przetestowałem na biznesowym ultrabooku MSI Prestige 14 AI+, który otrzymałem do testów od producenta. To maszyna bez dedykowanej karty graficznej, więc od razu zobaczysz, gdzie leży granica takiego sprzętu.
Artykuł sponsorowany przez firmę MSI, jednak wybór modeli i wszystkie testy szybkości przeprowadziłem osobiście.
Cały proces, od instalacji przez test Bielika po generowanie obrazów, pokazuję w filmie powyżej.
Do czego przydaje się lokalne AI
Zanim przejdziemy do sprzętu i parametrów, najważniejsze pytanie: co Ty z tego realnie będziesz miał. Oto zadania, które sam wykonuję u siebie, bez wysyłania czegokolwiek na zewnątrz:
- streszczenie dwudziestostronicowej umowy do pięciu punktów
- wyciągnięcie kwot i terminów z folderu faktur w formacie PDF
- przepisanie godzinnego nagrania rozmowy na tekst
- napisanie maila po polsku, który brzmi jak napisany przez człowieka
- zadawanie pytań do własnej dokumentacji firmowej
- wygenerowanie grafiki na potrzeby wpisu
- stworzenie muzyki i dźwięków tła do własnego projektu
Wszystko to dzieje się na dysku, w oknie zwykłego programu, bez konta i bez licznika zużycia. Żaden model chmurowy nie jest do tego potrzebny.
Trzy powody, dla których warto
Prywatność danych. Umowy, transkrypcje rozmów z klientami, dokumentacja firmowa. Prywatność jest tu najmocniejszym argumentem: lokalny model przetwarza je u Ciebie i nie musisz wysyłać niczego na zewnątrz. Chmura zawsze wymaga przesłania treści na cudzy serwer, a jeżeli pracujesz na danych klientów, to nie kwestia przewrażliwienia, tylko RODO.
Brak opłat za korzystanie. Model wystarczy pobrać raz i pracuje w nieskończoność. Przy zadaniach masowych, jak przepuszczenie dwustu transkrypcji przez streszczenie, różnica w rachunku wobec modelu chmurowego robi się odczuwalna.
Praca offline. Pociąg, samolot, hotelowe Wi-Fi, które ledwo zipie. Lokalny model leży na dysku i nie interesuje go zasięg.
I trzy powody, dla których możesz odpuścić
Uczciwie, bo inaczej pierwsze zetknięcie kończy się rozczarowaniem.
Musisz mieć mocny sprzęt. To bariera, o którą rozbija się najwięcej osób. Potrzebny jest komputer stacjonarny albo laptop, ale nie dowolny: albo wysokiej klasy ultrabook z najnowszym procesorem, albo maszyna z dedykowaną kartą graficzną. Na przeciętnym laptopie sprzed kilku lat model lokalny po prostu nie ruszy i piszę o tym szerzej w dalszej części.
Zużycie prądu. Jeżeli planujesz trzymać model uruchomiony przez całą dobę, na przykład jako asystenta podpiętego do własnych narzędzi, wliczaj to w koszty. Komputer z kartą graficzną pod obciążeniem potrafi pobierać kilkaset watów i przy pracy ciągłej zobaczysz to na rachunku.
Niższa jakość niż w chmurze. Najlepszy lokalny model, jaki uruchomisz u siebie, jest słabszy od najlepszego modelu chmurowego. To się nie zmieniło i szybko nie zmieni. Lokalnie wygrywasz prywatnością, kosztem i dostępnością, nie surową inteligencją.
Tekst, dźwięk, obrazy i wideo: co uruchomisz u siebie
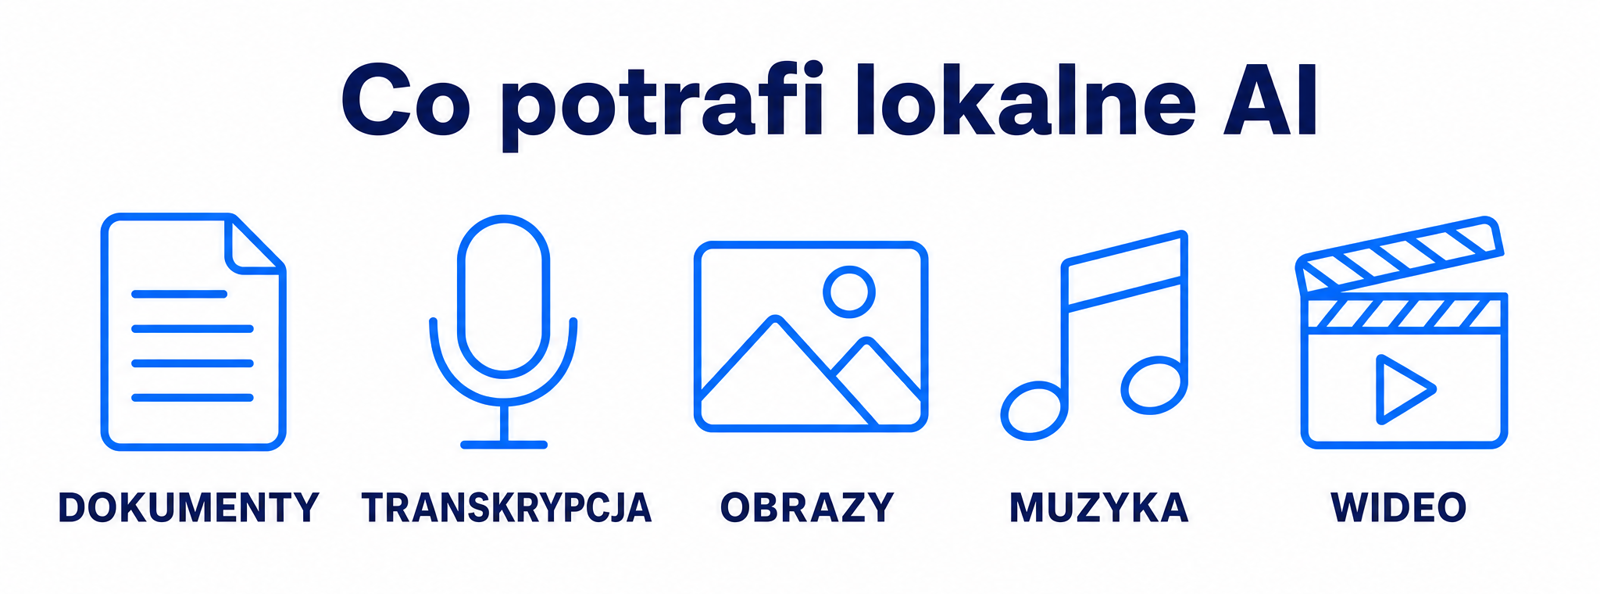
Pięć obszarów, z bardzo różnym progiem wejścia. Przy każdym piszę wprost, na jakim sprzęcie to realnie ruszy.
Praca z tekstem i dokumentami
Najdojrzalszy obszar i najmniej wymagający. Streszczanie, przepisywanie, poprawa stylu, wyciąganie danych z dokumentów. Najbardziej praktyczne z zastosowań to rozmowa z własnymi danymi: wskazujesz folder z dokumentami PDF, a model odpowiada na pytania na ich podstawie.
Wystarczy do tego niewielki model, więc ruszy praktycznie na każdym w miarę nowym komputerze. To jest ten obszar, w którym lokalne AI najszybciej zaczyna oszczędzać czas.
Transkrypcja mowy
Modele z rodziny Whisper zamieniają nagranie na tekst z dokładnością, która jeszcze niedawno wymagała płatnej usługi. U mnie to zastosowanie lokalnego AI, po które sięgam najczęściej.
Program Vibe robi to w całości na komputerze: wskazujesz plik, wybierasz język polski i po chwili masz tekst z podziałem na znaczniki czasu, gotowy do wyeksportowania jako napisy albo zwykły dokument. Liczy się na procesorze, w tle, więc w tym czasie możesz normalnie pracować.
Generowanie obrazów
Tu robi się poważnie. Model SDXL potrzebuje od sześciu do ośmiu gigabajtów pamięci, a nowszy Flux w wersji podstawowej od dziesięciu do dwunastu.
Prosty obraz na szybkim modelu powstaje w kilkadziesiąt sekund, ale przy pełnym SDXL albo Fluksie liczy się to już w minutach. To pierwszy obszar, w którym dedykowana karta graficzna zamienia ćwiczenie z cierpliwości w zwykłą pracę.
Generowanie dźwięku i muzyki
Najmniej znany obszar, a robi wrażenie. Do własnej gry generuję muzykę i pętle ambientu lokalnie, modelem Stable Audio 3 w wersji Medium. Cztery warianty jednego motywu, dzień, zmierzch, noc i świt, powstają u mnie na dysku i nigdy nie były w żadnej usłudze chmurowej.
Sam model potrzebuje około sześciu gigabajtów pamięci karty graficznej, u mnie chodzi na karcie z dwunastoma i samo wczytanie zajmuje kilkadziesiąt sekund. Bez dedykowanej karty jest to raczej ciekawostka niż narzędzie do pracy.
Generowanie wideo
Najcięższy przypadek z całej listy i jedyny, przy którym trzeba powiedzieć wprost: na laptopie tego nie zrobisz, niezależnie od tego, jak nowy masz procesor.
Modele wideo z otwartymi wagami, takie jak Wan czy LTX, potrzebują kilkunastu gigabajtów pamięci samej karty graficznej, a kilkusekundowy klip powstaje minutami nawet na mocnym komputerze stacjonarnym. To obszar zarezerwowany dla maszyn z naprawdę wydajną kartą, a przy dłuższych materiałach i tak wygodniej sięgnąć po usługę w chmurze.
Zasada jest prosta: im dalej od czystego tekstu, tym mocniejszego sprzętu potrzebujesz.
Od czego zacząć: program Jan
Do uruchomienia modelu na własnym komputerze nie potrzebujesz terminala ani znajomości programowania. Wystarczy jeden program z normalnym oknem, w którym piszesz tak samo jak w ChatGPT, tylko że wszystko dzieje się na Twoim dysku.
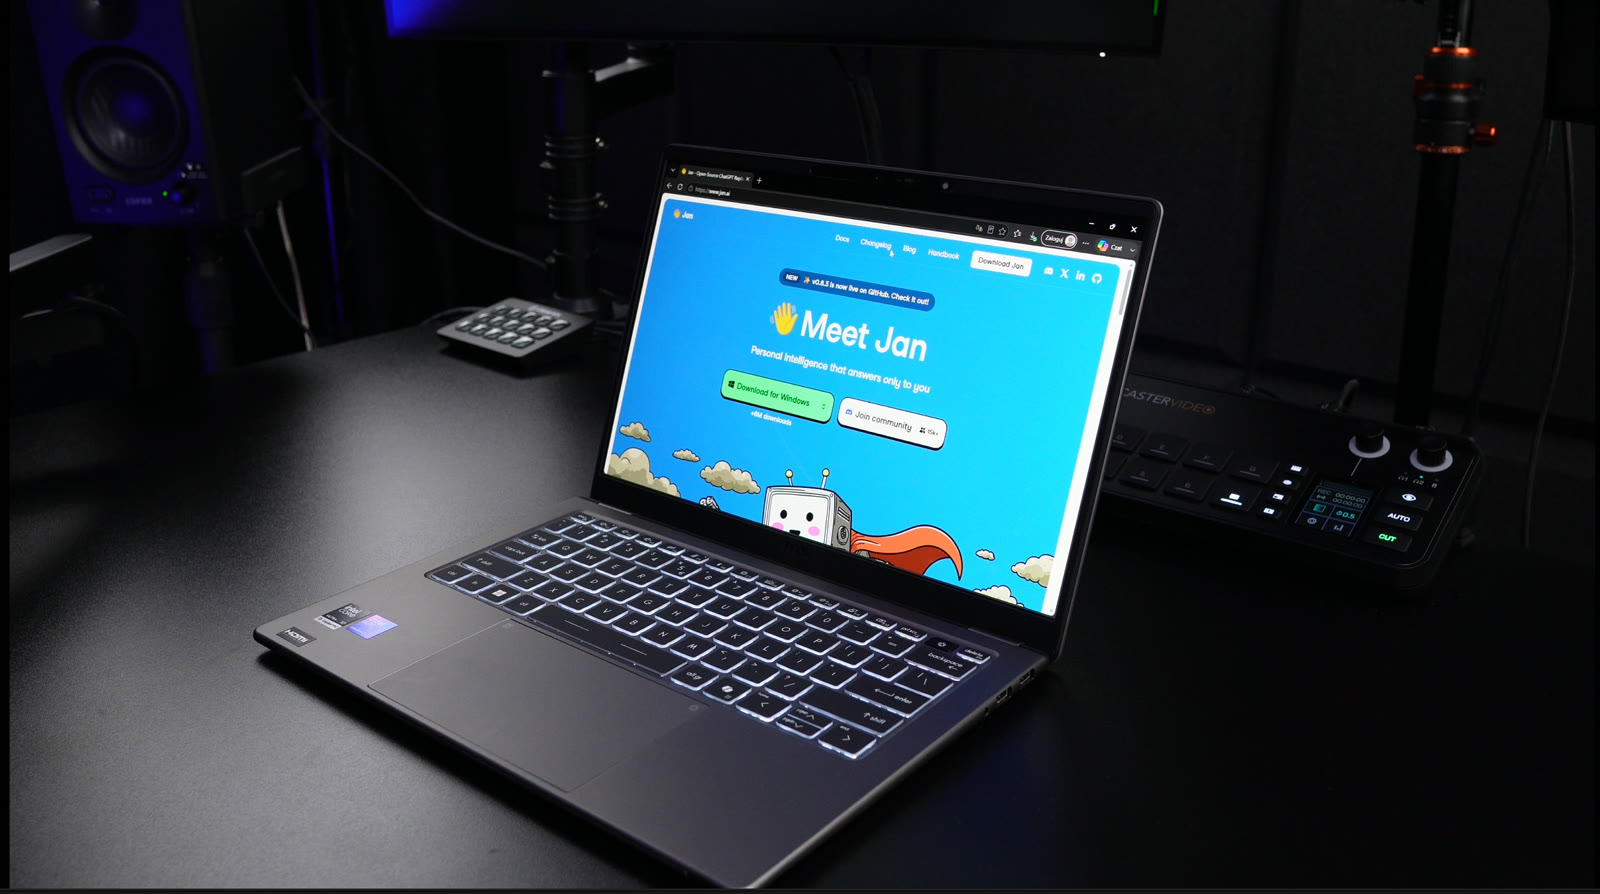
Najprościej zacząć od Jana. To darmowa aplikacja o otwartym kodzie, na Windowsa, macOS i Linuksa. Trzy rzeczy sprawiają, że jest dobrym pierwszym wyborem:
- ma wbudowaną wyszukiwarkę modeli. Nie szukasz plików po internecie, tylko wpisujesz nazwę w oknie programu i klikasz pobierz
- sam podpowiada, co uruchomisz. Sprawdza, ile masz pamięci, i przy każdym wariancie modelu pokazuje rozmiar pliku oraz to, czy wejdzie na Twój sprzęt
- nie zamyka Cię w jednym programie. Pod spodem pracuje silnik llama.cpp, ten sam, na którym opierają się LM Studio i GPT4All, więc pobrane modele zadziałają także tam
Start zajmuje kwadrans i wygląda tak:
- pobierz Jana ze strony jan.ai i zainstaluj jak każdy inny program
- przy pierwszym uruchomieniu pobierz model, który program sam proponuje. Na tym etapie nie kombinuj z wyborem, chodzi o to, żeby zobaczyć, jak to działa u Ciebie
- zadaj pierwsze pytanie i sprawdź, czy tempo odpowiedzi Ci odpowiada
- dopiero potem pobierz model dobrany pod swoje zadania, o czym za chwilę
Tyle wystarczy, żeby zacząć. Cała reszta tego tekstu to dobieranie modelu i sprzętu do tego, co faktycznie chcesz robić.
Bardziej zaawansowani sięgają po Ollamę. Pozwala ona uruchomić modele w tle i udostępnić je innym programom, na przykład narzędziu do notatek czy własnej automatyzacji. To już zastosowanie zaawansowane: daje większą kontrolę, ale konfiguracja wymaga pracy w terminalu.
Lokalne modele AI, od których warto zacząć
Nie ma sensu zaczynać od przeglądania setek nazw. Na start wystarczą dwa modele, jeden do polskiego i jeden do wszystkiego innego. Oba zainstalujesz w kilka minut i oba będą działać lokalnie, bez konta i bez sieci.
Gemma 4, uniwersalny model na co dzień
Model od Google, wielojęzyczny, dostępny w kilku rozmiarach. Wariant E4B waży około pięciu gigabajtów w kwantyzacji Q4, obsługuje ponad 140 języków i ma 128 tysięcy tokenów kontekstu, więc nadaje się na laptopa bez kompromisów. Wariant 12B jest wyraźnie mądrzejszy i to on jest moim codziennym wyborem, jeżeli tylko sprzęt pozwala.
Pełna nazwa do wyszukiwarki modeli: `unsloth/gemma-4-12b-it-GGUF`
Bielik v3, czyli polskie AI, które rozumie polski
Bielik to polski model językowy od zespołu SpeakLeash i dla polskiego użytkownika zmienia najwięcej. Najnowsza rodzina, oznaczona jako v3, dostępna jest w kilku rozmiarach, od 1,5 miliarda parametrów do 11 miliardów.
Na laptopa najlepszy jest wariant 11B w kwantyzacji Q4. Waży nieco ponad sześć gigabajtów, obsługuje 32 języki europejskie i został wytrenowany na ponad dwudziestu milionach instrukcji. Najważniejsze jest jednak to, czego nie widać w liczbach: Bielik był optymalizowany pod język polski, łącznie z własnym tokenizerem, więc nie tłumaczy w głowie z angielskiego. Przy pismach, mailach do klienta czy redakcji tekstu różnica wobec modeli wielojęzycznych jest wyraźna, zwłaszcza w odmianie.
Pełna nazwa do wyszukiwarki modeli: `speakleash/Bielik-11B-v3.0-Instruct-GGUF`, wariant Q4_K_M
Wpisz tę nazwę w wyszukiwarkę modeli w Janie, wybierz wariant Q4_K_M i po kilku minutach rozmawiasz z modelem po polsku. Co dokładnie znaczą te wszystkie skróty w nazwie pliku, wyjaśniam w następnej części.
Pozostałe modele, gdy te dwa przestaną wystarczać
- Gemma 4 E2B, około dwóch gigabajtów. Najmniejszy sensowny lokalny model AI, wchodzi praktycznie wszędzie
- gpt-oss 20B, około czternastu gigabajtów. Model OpenAI z otwartymi wagami, mocny w rozumowaniu
- Qwen3 Coder 30B, około dziewiętnastu gigabajtów. Do kodu, wymaga już poważnej pamięci
- Qwen3.6 35B-A3B, około dwudziestu trzech gigabajtów. Dziś najczęściej polecany model dla tych, którzy mają czym go uruchomić
Przy tym ostatnim warto się zatrzymać, bo dobrze pokazuje, w którą stronę to wszystko idzie. Mimo 35 miliardów parametrów przy każdym słowie pracuje tylko około trzech miliardów, więc odpowiada z prędkością małego modelu, a wie tyle, co duży. Do tego 256 tysięcy tokenów kontekstu, czyli spokojnie kilkaset stron naraz. Potrzebuje jednak około 23 gigabajtów pamięci, więc na ultrabooku go nie uruchomisz.
Wszystkie powyższe to modele typu LLM, czyli duże modele językowe pracujące na tekście, wytrenowane do przewidywania kolejnych słów. Osobną kategorią jest Whisper w wersji large-v3, który nie służy do rozmowy, tylko zamienia mowę na tekst.
Jak czytać nazwy modeli i nie pobrać za dużego
Nazwy modeli wyglądają jak kod z tablicy rejestracyjnej i to jest moment, w którym najwięcej osób odbija się od tematu. Groźne przestają być, kiedy raz rozbierzesz jedną z nich na części. W zapisie gemma-4-12b-it-Q4_K_M masz po kolei: rodzinę modelu, jej wersję, liczbę parametrów, tryb rozmowy i poziom kompresji.
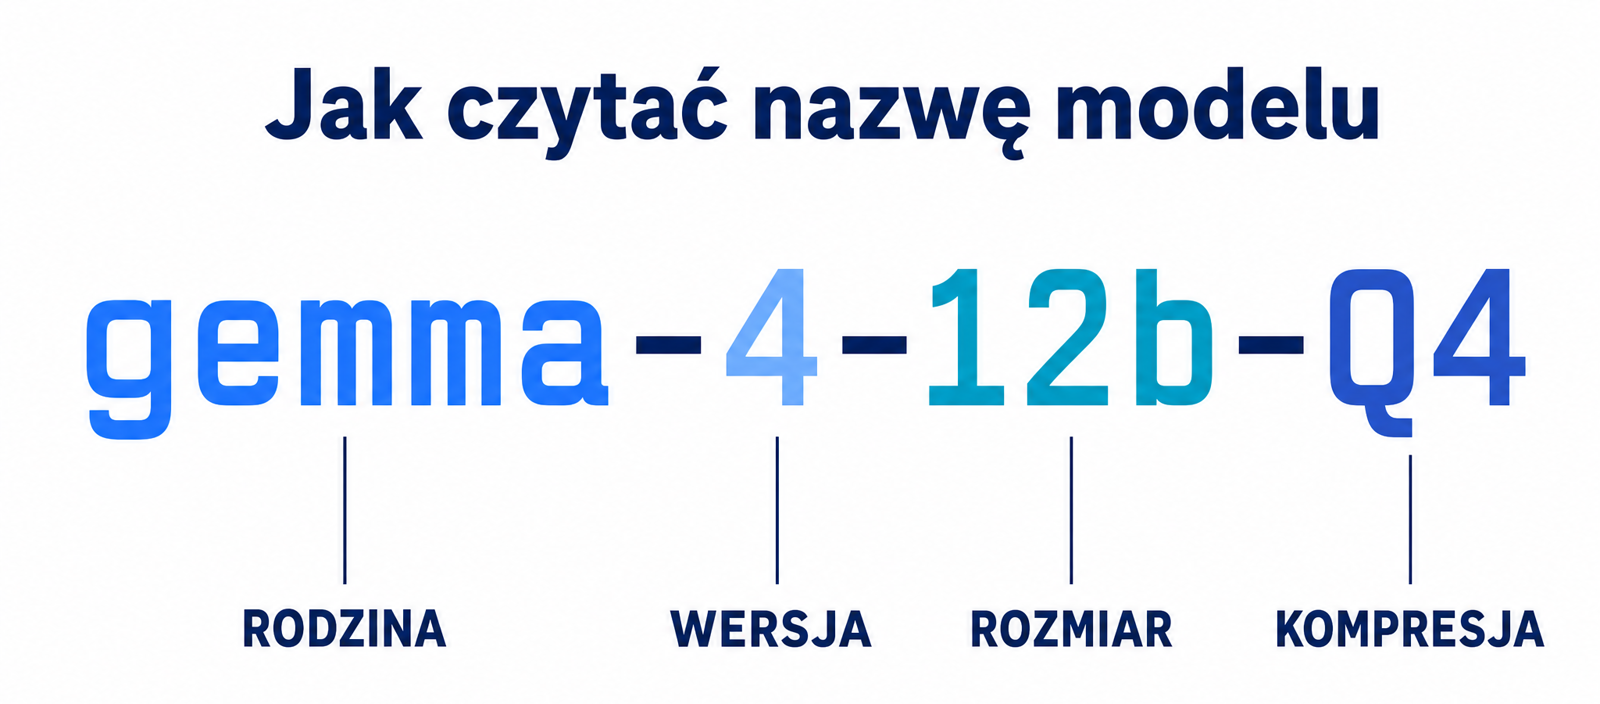
Do tego Jan przy każdym wariancie pokazuje rozmiar pliku w gigabajtach, więc jednym spojrzeniem sprawdzisz, czy model zmieści się w pamięci Twojego komputera. Warto jednak wiedzieć, skąd te liczby się biorą, a do tego wystarczą trzy pojęcia.
Wielkość modelu. Zapis 11B oznacza jedenaście miliardów parametrów. Im większa liczba, tym model mądrzejszy i tym więcej pamięci zajmuje. To właśnie ta liczba decyduje, czy uruchomisz model u siebie.
Kwantyzacja. To kompresja modelu. Oznaczenie Q4 jest dziś standardem: model chudnie mniej więcej czterokrotnie, a jakość spada na tyle nieznacznie, że w normalnej pracy tego nie zauważysz. Bez kwantyzacji lokalne AI w ogóle nie miałoby sensu na sprzęcie domowym.
Pamięć. Model musi zmieścić się w pamięci w całości. Na karcie graficznej to VRAM, czyli pamięć własna karty. W laptopie bez dedykowanej karty układ graficzny nie ma swojej pamięci i dzieli się nią z systemem.
Praktyczna reguła, która wystarcza w dziewięciu przypadkach na dziesięć: model w Q4 waży w gigabajtach mniej więcej połowę liczby swoich miliardów parametrów. Model 14B to około dziewięciu gigabajtów. Ta reguła wystarczy, żeby ocenić, czy model lokalny w ogóle wejdzie na Twój sprzęt.
Do tego jedna miara wyniku: tokeny na sekundę. Token to mniej więcej pół polskiego słowa. Poniżej 10 tokenów na sekundę praca robi się męcząca. Kilkanaście to mniej więcej tempo czytania i przy tej wartości korzysta się z modelu normalnie. Powyżej 30 odpowiedź pojawia się szybciej, niż zdążysz ją przeczytać.
Jaki model uruchomiłem na MSI Prestige 14 AI+
Sprzęt: MSI Prestige 14 AI+ D3MG. Intel Core Ultra X7 358H, grafika Intel Arc B390 z dwunastoma rdzeniami Xe3, NPU o wydajności 50 TOPS, 32 GB pamięci LPDDR5X, ekran 14 cali OLED. Biznesowy ultrabook, sprzęt kupowany przede wszystkim do pracy i z myślą o mobilności.
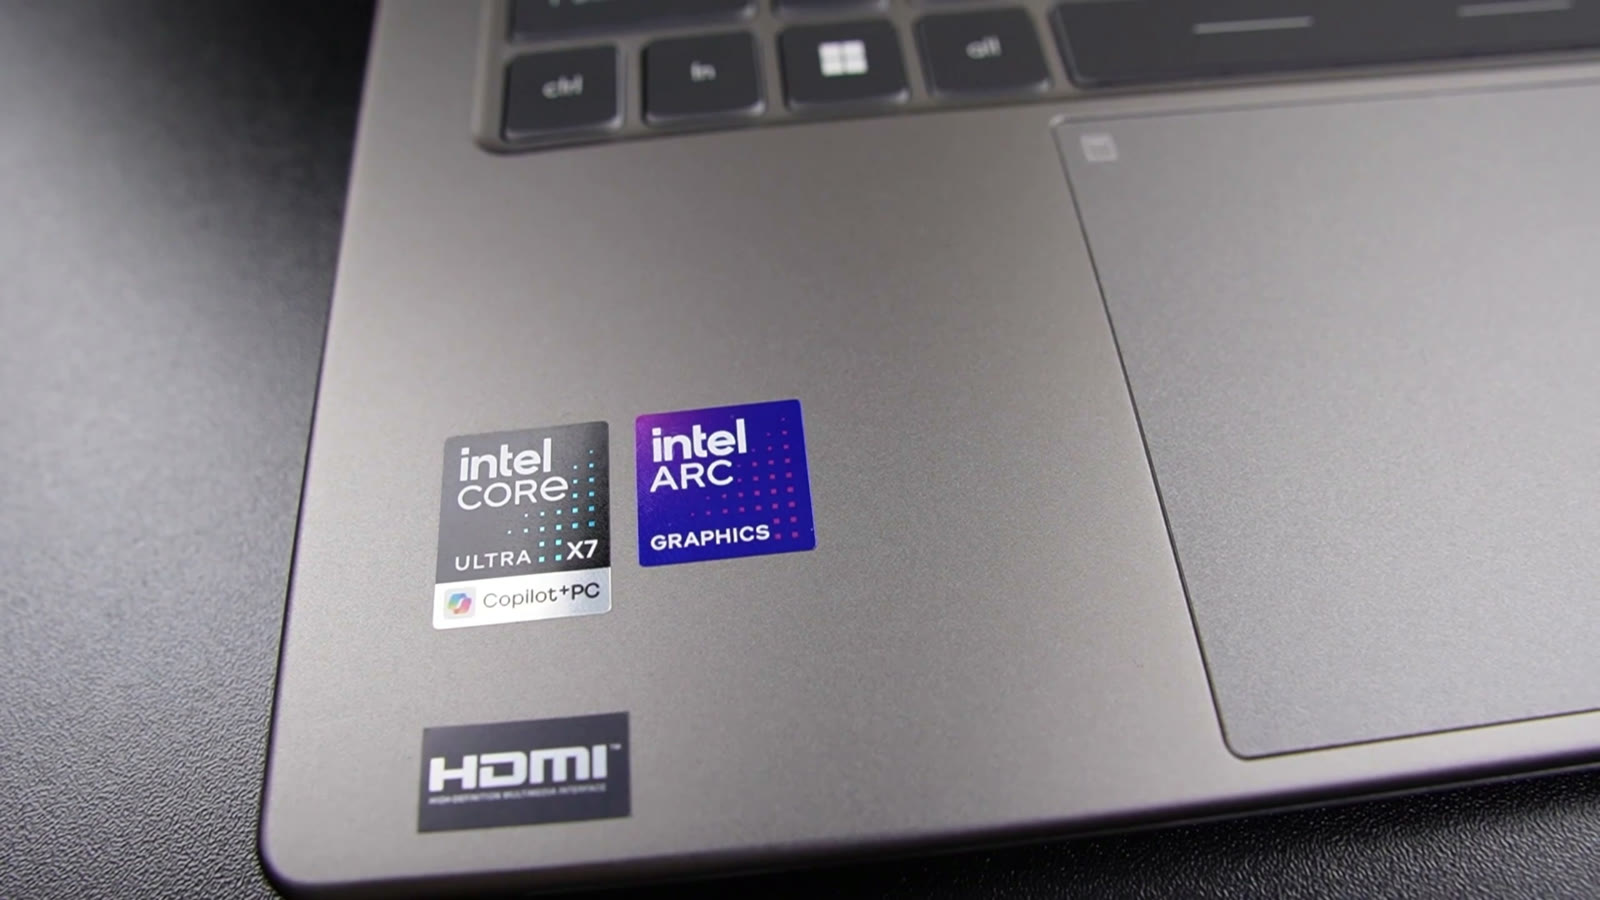
Wszystko, co opisuję niżej, robiłem w aplikacji Jan, na modelach w kwantyzacji Q4, bez podkręcania czegokolwiek w ustawieniach. Jan liczył na backendzie Vulkan, czyli tym, który program sam wskazuje dla grafiki Intela.
Ten laptop nie ma dedykowanej karty graficznej. Ma zintegrowaną Arc B390, która nie dysponuje własną pamięcią: korzysta ze współdzielonej pamięci LPDDR5X, tej samej, z której korzysta procesor. Dlatego mówię tu o RAM, bo te 32 GB to jedyna pula pamięci w tym komputerze i to ona wyznacza sufit modeli. Model nie był przy tym dzielony między grafikę a procesor: mieścił się w całości i liczył go Arc B390. Rozpisuję to dokładniej w dalszej części, przy okazji doboru sprzętu.
Dlaczego to w ogóle działa. O prędkości decyduje przepustowość pamięci, a ta w Panther Lake jest wysoka jak na cienki laptop. Procesor obsługuje LPDDR5X do 9600 MT/s, co daje maksymalnie około 153 GB/s, a w praktyce, przy kościach montowanych w laptopach tej klasy, mówimy o okolicach 130-150 GB/s. Dla porównania: dwukanałowy DDR4-3200 w typowym desktopie to około 51 GB/s, DDR5-5600 około 90 GB/s, a karta pokroju RTX 4060 ma 272 GB/s. Ultrabook jest więc wyraźnie bliżej desktopowego RAM niż karty graficznej, ale dwa razy szybszy od starszych konstrukcji.
Co to znaczy w praktyce. Gemma 4 12B w kwantyzacji Q4, czyli plik 6-7 GB, daje na tym laptopie 12-14 tokenów na sekundę. Tekst pojawia się więc nieco szybciej, niż zdążysz go przeczytać. Krótka odpowiedź na kilka zdań to kilkanaście sekund, pełna strona tekstu to około minuty. Modele w chmurze są kilka razy szybsze i nie ma co tego ukrywać.
Stąd biorą się te 85 sekund na podsumowanie dwóch faktur w filmie: model musi najpierw przeczytać oba pliki, a dopiero potem zaczyna pisać tabelę. To są realne czasy z tej maszyny, bez przyspieszonego montażu. Jeżeli masz komputer z RTX-em, Twoje będą krótsze.
Bielik 11B, czyli plik nieco ponad sześć gigabajtów, zachowywał się podobnie. Oba modele mieszczą się tu w pamięci w całości i w tym tkwi cały sekret: dopóki model się mieści, cienki laptop radzi sobie bez problemu.
Osobno sprawdziłem generowanie obrazów. Jeden obraz w rozdzielczości 1080 na 1080 pikseli, na szybkim modelu z rodziny turbo, powstał w około czterdzieści sekund. Przy pełnym SDXL albo Fluksie w wersji podstawowej mówimy już o minutach na obraz, i to jest pierwszy moment, w którym dedykowana karta graficzna naprawdę zmienia komfort pracy.
Ważne zastrzeżenie
Jeżeli masz laptopa ze starszą grafiką zintegrowaną i wolniejszą pamięcią, lokalne AI będzie działać znacznie wolniej niż na nagraniu. Arc B390 to obecnie najmocniejsza zintegrowana grafika Intela, więc nie jest punktem odniesienia dla sprzętu sprzed kilku lat. Tam realnie zejdź do modeli 4B i 8B.
Powyższe liczby dają Ci kierunek, ale ostateczną odpowiedź da tylko Twoja maszyna. Najprostsza metoda: zainstaluj Jana i przetestuj konkretny model u siebie. Program przy każdym modelu pokazuje, czy zmieści się na Twoim sprzęcie, ostrzeżeniem o wolnym działaniu albo czerwonym krzyżykiem, a pod odpowiedzią podaje realną liczbę tokenów na sekundę. Zacznij od modelu 8B, sprawdź prędkość, a potem próbuj wyżej. Zajmie to kwadrans i będzie warte więcej niż każda tabelka, bo Jan liczy możliwości Twojej konkretnej maszyny, a nie średnią z internetu.
Jakiego sprzętu potrzebujesz do AI?
Jak działa lokalny model i dlaczego wszystko rozbija się o pamięć
Model to jeden duży plik na dysku. Żeby z niego skorzystać, program musi wczytać go w całości do pamięci, a potem przy każdym słowie odpowiedzi przeliczyć całą jego zawartość. Dlatego, żeby przetwarzać tekst szybko, liczy się nie tyle surowa moc obliczeniowa, ile ilość pamięci i szybkość, z jaką procesor albo karta graficzna potrafi ją czytać.
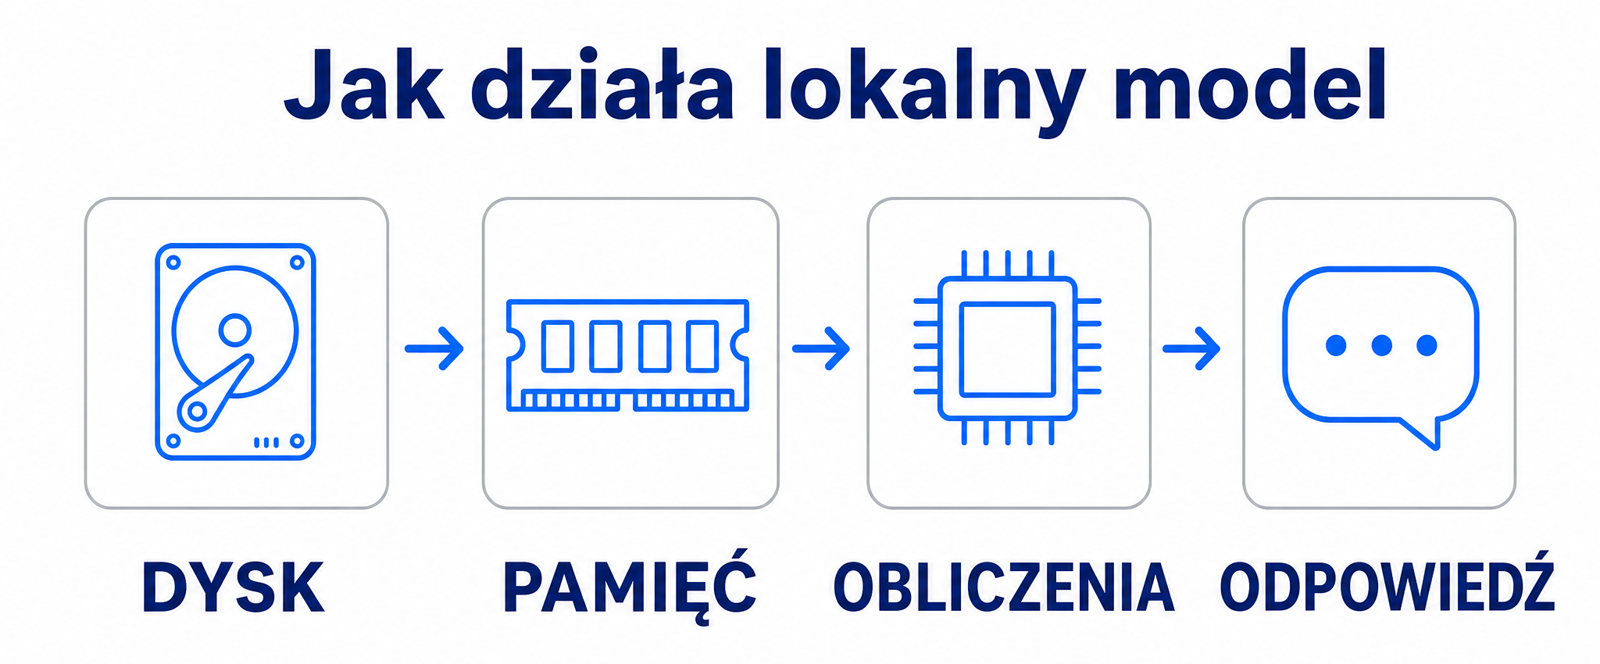
Wynika z tego prosta zasada: jeżeli model mieści się w pamięci, działa szybko. Jeżeli się nie mieści, część ląduje w wolniejszej pamięci systemowej i prędkość spada kilkukrotnie.
Dlaczego zintegrowana grafika zwykle nie wystarcza i dlaczego ten laptop jest wyjątkiem
Zacznę od rzeczy, którą trzeba powiedzieć wprost: zintegrowana grafika przez lata była dla lokalnego AI ślepą uliczką. Jeżeli masz laptopa sprzed kilku lat z układem graficznym wbudowanym w procesor, modele językowe będą na nim działać na tyle wolno, że szybciej wykonasz zadanie ręcznie. To się nie zmieniło i nie warto na tym tracić czasu.
Testowany Prestige jest wyjątkiem z dwóch konkretnych powodów. Pierwszym jest procesor Intel Core Ultra X7 358H, czyli najnowsza generacja układów Intela do laptopów. Drugim, ważniejszym, jest grafika Intel Arc B390: najmocniejszy obecnie zintegrowany układ graficzny Intela, zbudowany na dwunastu rdzeniach Xe3. To nie jest grafika dodana po to, żeby obraz się wyświetlił, tylko układ, który realnie liczy.
Do tego dochodzi 32 GB pamięci LPDDR5X, którą procesor dzieli z grafiką. W praktyce oznacza to, że mniejsze modele nie tylko się tu mieszczą, ale działają na tyle sprawnie, że da się ich używać do realnej pracy: streszczania dokumentów, transkrypcji, porządkowania notatek, pomocy przy pisaniu.
RAM czy VRAM: co naprawdę decyduje
W filmie pokazuję, jak sprawdzić w Janie, czy model zadziała na Twojej maszynie. Poniżej rozwijam temat dla tych, którzy chcą rozumieć, co się dzieje pod spodem, bo w materiale dla początkujących nie było na to miejsca.
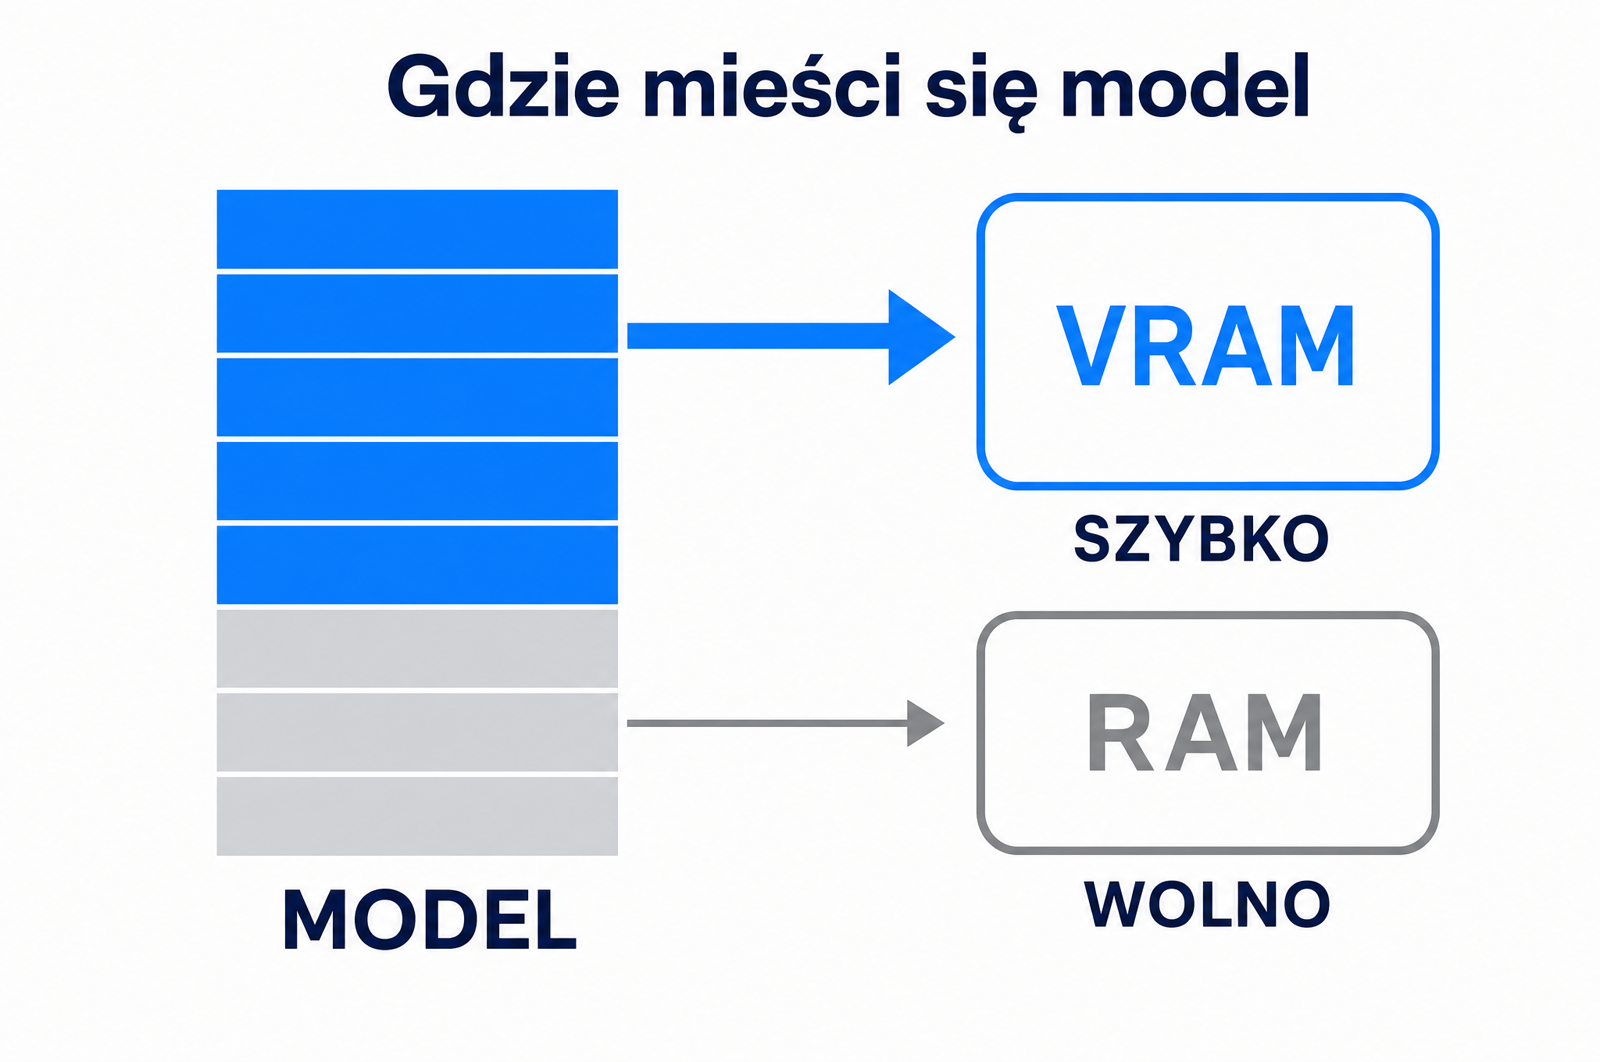
RAM jest ważny, bo decyduje, czy model w ogóle się załaduje. Jeżeli jednak masz dedykowaną kartę graficzną, to najpierw liczy się VRAM, czyli pamięć własna karty.
Działa to tak: model dzieli się na warstwy. Tyle warstw, ile zmieści się w VRAM, ląduje na karcie, a reszta zostaje w zwykłym RAM i liczy je procesor. Każda odpowiedź przechodzi przez wszystkie warstwy, więc tempo dyktuje ta wolniejsza część. Karta nadal pomaga, ale nawet ćwierć modelu poza VRAM potrafi spowolnić pracę kilkukrotnie. Skala zależy od silnika: Jan pracuje pod spodem na llama.cpp, gdzie taki podział warstw kosztuje sporo. Nie zobaczysz przy tym żadnego błędu, model po prostu zacznie działać znacznie wolniej. Do tego kontekst rozmowy również zajmuje VRAM i rośnie w trakcie, więc przy długiej rozmowie miejsca ubywa.
Ile to waży, na przykładzie Gemmy z filmu. Gemma 4 12B to dwanaście miliardów parametrów. Kwantyzacja decyduje, ile bitów przypada na jeden parametr, i to ona ustala rozmiar pliku:
- Q4 to około 6-7 GB, czyli wariant, który pobieram w filmie
- Q5 to około 8 GB
- Q8 to około 12,5 GB
- bez kwantyzacji to około 24 GB
Do tego dolicz 1-2 GB na kontekst. Ta sama Gemma zmieści się więc na karcie z 8 GB pamięci w wariancie Q4, ale w Q8 już nie. Jeżeli masz kartę z 8 GB VRAM, bierz Q4.
W skrócie, licząc pamięcią karty graficznej:
- 8 GB VRAM to modele do 8B oraz 12B w kwantyzacji Q4
- 12-16 GB VRAM to modele 12-14B, w praktyce najlepszy kompromis
- 24 GB VRAM to modele 27B w Q4, choć przy długim kontekście robi się ciasno
Pamięć współdzielona, czyli trzeci wariant
Powyższy podział na RAM i VRAM zakłada, że masz dedykowaną kartę graficzną z własną pamięcią. Coraz częściej spotkasz jednak trzeci układ: pamięć współdzieloną, nazywaną też zunifikowaną (po angielsku unified memory). Tak działają nowe procesory Intela i AMD do laptopów oraz układy Apple z serii M.
W takiej konstrukcji jest jedna pula pamięci, a procesor i grafika sięgają do niej razem. Nie ma więc kopiowania modelu z RAM do VRAM ani dzielenia go na dwie części, a sufit wyznacza po prostu ilość pamięci w komputerze. To dlatego ultrabook z 32 GB potrafi wczytać model, który nie zmieści się na karcie z 8 GB.
Cena tego rozwiązania jest jedna: przepustowość. Pamięć w laptopie jest wolniejsza od pamięci wlutowanej w kartę graficzną, więc model się zmieści i policzy, ale wolniej. To kompromis, nie darmowy obiad.
Do czego służy NPU i czy naprawdę pomaga?
Prestige ma NPU piątej generacji o wydajności 50 TOPS i naklejkę Copilot+. Marketing tego nie mówi, więc powiem ja: popularne programy do lokalnych modeli językowych, w tym Jan i Ollama, nie liczą na NPU. Liczą na procesor i na układ graficzny.
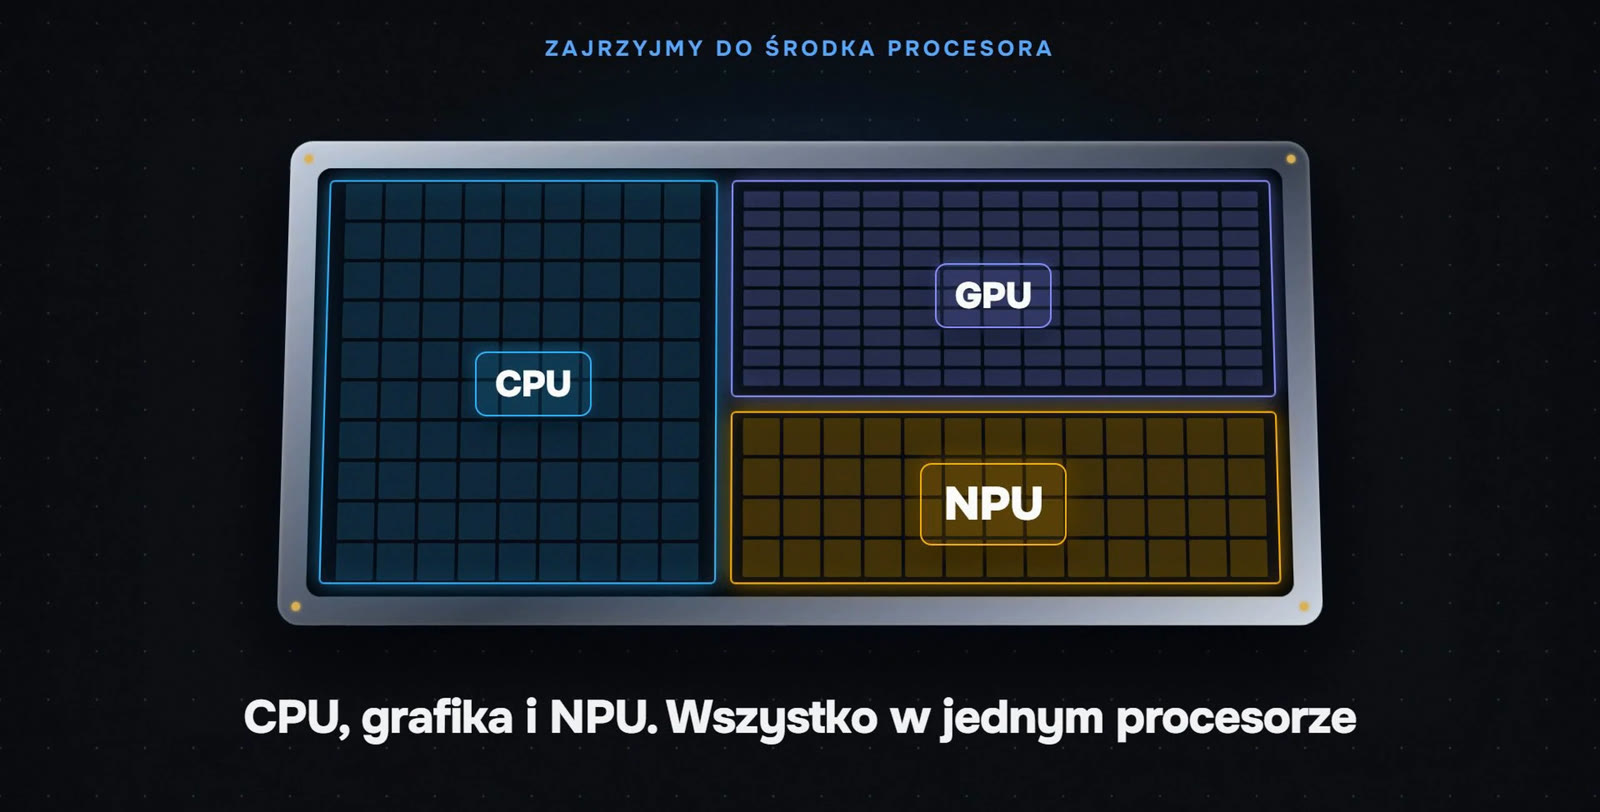
NPU robi co innego i robi to dobrze: rozmycie tła i korekcja wzroku na kamerze, napisy na żywo, transkrypcja, część efektów w programach kreatywnych. Jego przewagą nie jest szybkość, tylko pobór prądu. Zadanie, które na procesorze zjada baterię, na NPU idzie w tle niemal za darmo.
Odpowiedź brzmi więc: pomaga, ale nie tam, gdzie większość osób się tego spodziewa. O szybkości modelu językowego decyduje przede wszystkim przepustowość pamięci, a nie liczba TOPS w układzie NPU. Jeżeli ktoś kupuje laptopa z NPU, licząc na to, że dzięki temu uruchomi większy model, kupuje z błędnego powodu.
Kiedy potrzebna jest dedykowana karta graficzna i na co patrzeć przy jej wyborze
Nie ma sensu udawać, że ultrabook zastąpi komputer z dedykowaną kartą graficzną, jeżeli lokalny model ma pracować codziennie. Karta ma własną, znacznie szybszą pamięć i wielokrotnie więcej jednostek obliczeniowych, więc większe modele będą na niej działać wyraźnie szybciej.
Dlatego jeżeli AI ma być Twoim głównym narzędziem pracy i zależy Ci na większych modelach, celuj w komputer z dedykowaną kartą wyposażoną w co najmniej szesnaście gigabajtów własnej pamięci. Taki sprzęt pozwoli komfortowo uruchamiać modele średniej wielkości. Prestige jest natomiast bardzo dobrym wyborem dla kogoś, kto pracuje w trasie i chce mieć dobrą wydajność do pracy oraz okazjonalnie uruchomić lokalne AI do mniejszych zadań.
Przy wyborze karty obowiązuje jedna zasada, ważniejsza od wszystkich benchmarków: liczy się ilość pamięci, nie wydajność w grach. GPU o trzydzieści procent szybsze w grach, ale z ośmioma gigabajtami zamiast szesnastu, będzie do modeli AI po prostu gorsze. Model albo się mieści, albo nie. To nie jest płynne pogorszenie, to jest ściana. Sprzęt dobieraj więc pod model, który chcesz uruchomić, a nie pod wyniki w grach.
Poza pamięcią samej karty liczy się jeszcze pamięć RAM w komputerze: przy szesnastu gigabajtach większe modele zaczynają działać z zadyszką, przy 32 GB robi się swobodnie. 32 GB to dziś dobra ilość na start i przy modelach do kilkunastu miliardów parametrów w zupełności wystarczy. Jeżeli celujesz wyżej, w modele 30B i większe, planuj 64 GB, zwłaszcza przy pamięci współdzielonej, gdzie z tej samej puli korzysta również grafika.
Na koniec jedno uściślenie, bo bywa to przekręcane. Grafika Arc B390 w laptopie korzysta z architektury Xe3, czyli z rozwinięcia Xe2, na której Intel zbudował dedykowane karty Arc serii B. To bliska rodzina, ale nie ten sam układ: karty do komputerów wciąż opierają się na Xe2, a dedykowanych kart na Xe3 nie ma jeszcze w sprzedaży. Dla lokalnego AI i tak ważniejsze jest co innego niż nazwa architektury: ile pamięci ma Twój sprzęt i jak szybka ona jest.
Podsumowanie: jak zacząć pracę z lokalnym AI
Jeżeli chcesz sprawdzić, czy lokalne AI jest dla Ciebie, i masz najnowszego ultrabooka pokroju testowanego MSI Prestige 14 AI+, śmiało spróbuj. Mniejsze modele ruszą i zrobią to na baterii, offline i bez wysyłania czegokolwiek na zewnątrz.
Jeżeli masz starszego laptopa ze zintegrowaną grafiką, odpuść sobie. Nie uruchomisz na nim żadnego sensownego modelu i skończy się to wyłącznie straconym wieczorem. Komputer stacjonarny z dedykowaną kartą wyposażoną w minimum 12 GB VRAM da Ci już zdecydowanie większy komfort pracy, a lokalny model AI przestanie być kompromisem. A jeżeli marzą Ci się największe dostępne modele, to szykuj się na wydatek naprawdę poważny.
Dobra wiadomość jest taka, że ta dziedzina zmienia się bardzo szybko. Modele są z miesiąca na miesiąc lepiej optymalizowane i potrafią coraz więcej przy tych samych wymaganiach, a rzeczy, które jeszcze niedawno wymagały serwerowni, dziś uruchamiam na laptopie w pociągu. Pełne wejście lokalnego AI do codziennej pracy jest dopiero przed nami, ale kierunek jest przesądzony. Warto sprawdzić już teraz, jak to działa u Ciebie.
Narzędzia i modele z filmu
Programy
Modele na start
Pełną nazwę wklej w wyszukiwarkę modeli w Janie.
- Polski tekst i pisma: `speakleash/Bielik-11B-v3.0-Instruct-GGUF`, wariant Q4_K_M
- Codzienne zadania: `unsloth/gemma-4-12b-it-GGUF`
- Transkrypcja: Whisper large-v3, w aplikacji Vibe
Sprzęt
Testowany laptop: MSI Prestige 14 AI+, Intel Core Ultra X7 358H, Intel Arc B390, 32 GB RAM, 1 TB SSD, ekran OLED.
Cała seria: MSI Prestige w sklepie producenta
Źródła
Dane techniczne w tekście pochodzą z oficjalnych kart modeli i materiałów producentów:
- Bielik 11B v3 Instruct, karta modelu
- Gemma 4, zapowiedź Google
- Gemma 4 12B w formacie GGUF
- Intel Core Ultra X7 358H, specyfikacja producenta
- MSI Prestige 14 AI+ D3M, specyfikacja producenta
Obserwacje na temat szybkości pochodzą z mojej własnej pracy na sprzęcie opisanym w tekście.
Materiał powstał we współpracy z firmą MSI. Sprzęt do testów udostępnił producent. Wyniki pomiarów i wnioski są moje własne.

Autor Krzysztof Gonet
Nazywam się Krzysztof Gonet. To miejsce powstało, aby pomóc Ci w stworzeniu zyskownego biznesu online opartego na Twojej pasji i talentach, abyś mógł robić to, co daje Ci satysfakcję, i poprzez Twoją pracę zmieniać świat na lepsze. Dowiedź się więcej o autorze.